
Cloud- & Plattform-Engineering
Consulting für Teams, die anspruchsvolle
Infrastruktur betreiben.
esTEAM8 (/ˈes.tə.meɪt/) — unabhängiges Consulting für Cloud- und Plattform-Engineering über AWS, Azure und Google Cloud hinweg. Ich helfe Teams, zuverlässige und sichere Plattformen zu entwerfen, zu migrieren und zu betreiben.
Kontakt aufnehmenEin Ansprechpartner für alle großen Cloud-Plattformen
Herstellerneutrale Beratung, praxisnahe Umsetzung auf der Plattform, die Sie einsetzen.
Google Cloud
GKE, VPC-Design, IAM und Plattform-Engineering auf GCP.
Microsoft Azure
AKS, Networking, Identity (Entra ID) und Enterprise Landing Zones.
AWS
Landing Zones, IAM, EKS, Kostenoptimierung und Well-Architected Reviews.
Kernkompetenzen
Durchgängige Plattform-Kompetenz — von der Architektur bis zum Einsatz um 3 Uhr nachts.
Kubernetes
Cluster-Architektur, GitOps, Skalierung, Upgrades und Härtung für produktive Workloads.
DevOps
CI/CD-Pipelines, Infrastructure as Code und Developer-Platform-Enablement.
Sicherheit
Cloud-Sicherheitsstrategie, IAM nach dem Least-Privilege-Prinzip, Secrets-Management und Compliance-Readiness.
Netzwerk
VPC-/VNet-Design, hybride Konnektivität, Load Balancing und Zero-Trust-Netzwerkarchitektur.
SRE
SLOs/SLIs, Observability, Incident Response und Reliability-Engineering-Praktiken.
Softwareentwicklung
Backend-Systeme, Automatisierungs-Tools und pragmatische Softwareauslieferung.
Warum mit mir arbeiten
- 10+ Jahre Erfahrung im gesamten SDLC — von Java/Spring-Boot-Entwicklung über Site Reliability Engineering bis zur Cloud-Architektur.
- Google Cloud Certified Professional Cloud Architect mit produktiver Kubernetes-, GitOps- und IaC-Erfahrung im großen Maßstab.
- Praxisnahe Umsetzung statt nur Folien — ich entwerfe, baue und übernehme die Bereitschaft.
- Herstellerneutrale Beratung — tief verwurzelt in Cloud-Native-Technologien, angewendet über AWS, Azure und GCP hinweg.
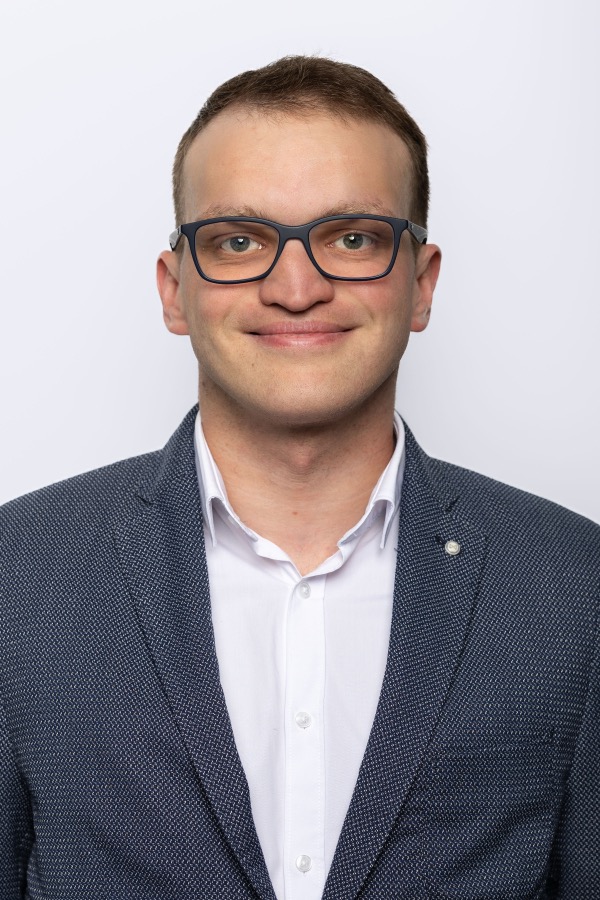
Ich bin Tomasz, ein in Dresden ansässiger, Google Cloud Certified Professional Cloud Architect mit über 10 Jahren Erfahrung im gesamten Software-Lebenszyklus — von der Backend-Entwicklung in Java und Spring Boot bis zum Betrieb produktiver Kubernetes-Plattformen als Site Reliability Engineer. Ich habe Observability standardisiert (Prometheus, Thanos, Grafana, Jaeger), Incident Response geleitet und GitOps-basierte Infrastruktur mit Pulumi und Flux für Plattformen aufgebaut, die mehrere Engineering-Teams unterstützen. Diese produktionsreife Sorgfalt bringe ich in unabhängiges Consulting ein — und helfe Teams, zuverlässig über AWS, Azure und Google Cloud hinweg zu entwerfen, zu migrieren und zu betreiben.
Lassen Sie uns sprechen
Haben Sie eine Herausforderung rund um Cloud, Kubernetes oder DevOps? Melden Sie sich.